10月14日,“材华·MatVerse”百亿参数材料多模态大模型发布,由苏州国家实验室联合上海人工智能实验室、上海交通大学研发。材料大模型越做越大,一个更实际的问题随之浮上来:算力与验证,成了AI for Materials(AI4M)绕不开的下一道关口。
带着这个问题,我们与芯培森联合创始人、总经理樊正伟聊了聊,请他谈谈芯培森这家企业为什么先做算力,以及模型热潮之下,材料研发的基础设施还缺什么。
材料大模型热潮:候选越多,评估越贵
问:怎么看待这波材料大模型热潮?
樊正伟先给了肯定:材料研发的第一步是提出候选方案,大模型把这一步的效率显著提高,方向没有问题。但他提醒,材料研发的完整链路是“提出—评估—验证”,大模型解决的只是第一环。候选越多,下游的评估与验证计算就越重——每一个候选结构都要经过原子级模拟,回答“稳不稳定、性能够不够”。上游打开的想象空间,最终都要落到下游的算力账上,所以在他看来,模型越强,专用算力反而越缺不得。
专用算力专在哪里:芯培森APU的答案
问:为什么要开发专用算力?
樊正伟的答案从芯培森APU(Atomistic Processing Unit,原子级物质计算专用算力单元)的定位讲起:它面向大体系的机器学习分子动力学(MLMD)模拟设计,采用非冯·诺依曼专用芯片架构,让计算紧靠存储位置参与运算。在他的描述里,算法与芯片的协同设计本就是一件事:势函数的神经网络做轻量化,芯片照着它的计算特征去设计,效率才能最大化。系统层面,芯培森采用超异构计算架构(CPU+GPU+APU协同),三类算力分工协作。据介绍,面向MLMD、密度泛函理论(DFT)这两类代表性计算路线,芯培森APU相较通用算力,计算速度有显著提升、能耗有显著下降。
问:算力之外,材料计算还缺什么?
算力只是一半,另一半是方法与验证。计算方法,要有所选择:DFT精度高,但计算量随体系规模按更高的幂次放大;经典分子动力学(CMD)覆盖面大,精度却低;MLMD在精度与速度之间找平衡。验证方面,标准很朴素:计算结果要能对标实验值与文献基准,才能进入研发决策。芯培森·SwiftMater把方法和验证落成了可交付的服务:这个2026年9月10日发布的品牌,首个服务产品聚焦固态电池电解质,交付标准是“准时、准确、可溯源”,三层质控体系与法律级赔付保障双线并行兜底。合适的计算方法配合专用算力,评估与验证才能立住;而这条链要真正转起来,还得靠会用工具的人。
把工具交到人手里:芯培森的MLMD培训
问:为什么培训在这个阶段成了重头戏?
工具交到手里,考验才刚开始。樊正伟并不讳言,设备与工具交付之后,使用门槛是最现实的难题——会不会用、用得对不对,直接决定这笔投入能不能变成研发效率。10月21日至22日,首期MLMD实战训练营在广州举办,两天十一个教学模块:学员要亲手跑通完整算例,把模拟结果与实验值或文献基准逐项对照;第二天进入APUMD环节,也就是在芯培森APU上跑分子动力学,学员用自己训练出来的势函数,完成大规模、长时间尺度的整套模拟。结营之后,课程指导老师还将通过学员社群,就实际使用中遇到的问题持续答疑;企业内训则按客户自己的材料体系出算例。在他的归纳里,算力、工具、方法、人,凑成材料计算进入研发流程的完整链条,缺哪一环都转不起来。
下一步:把链条做完
问:接下来怎么走?
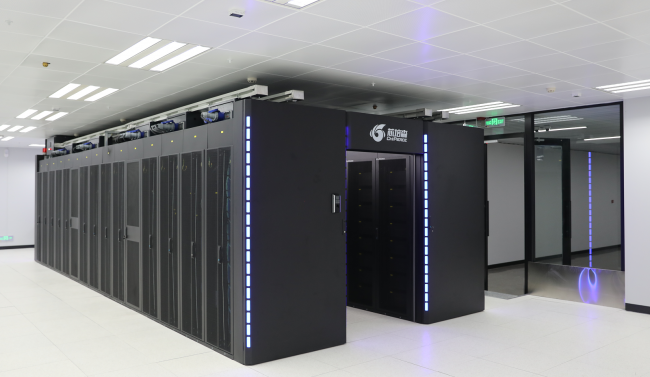
樊正伟给出两个关键词:迭代与合作。迭代这一端,工具和算力两条线同时往前推:智能体芯培森·MaterPlato接过调参、排错这些重复工序,超级终端芯培森·MaterHaven负责高速算力,算力底座落在大湾区的芯培森合资赫曦原子智算中心,100台赫曦服务器已完成部署。合作那一端,道理很朴素:材料研发的链条足够长,没有哪一家能把每一环都做完,开放合作比单打独斗更现实。芯培森希望与产业链各方协同,把服务的边界继续往外推。
樊正伟在多次对外交流中反复回到同一个出发点:材料企业要的东西其实很具体。做电池的,想知道电解质配方里哪一种离子电导率更高;做金属的,想把某种铝合金的导电率再提一点。问题各不相同,问到根上却是一回事:需要的是一组算得动、对得上实验的数字,而不是宏大叙事。材料大模型越强,专用算力越缺不得,芯培森正把这道题做成材料企业用得起的答案。
